林棟樑
為諾貝爾基金會選物理獎得主的瑞典皇家科學院, 大概也體會到人工智慧(AI)對人類社會的將來會有極大的衝擊, 所以2024年的物理獎就頒發給兩個對AI基礎貢獻極大的科學家: 多倫多大學的Geoffrey Hinton及普林斯頓大學的John Hopfield. 其實, 在2015年年底創立的OpenAI實驗室, 就開始研究如何把AI商業化. 在2017 年, 一篇重量級的論文出爐: “Attention is All You Need”; 這篇論文提出了 Transformer 架構這個概念, 立刻變成AI 架構的主流, OpenAI也跟著採用. 經過幾年的研究, OpenAI在2022的11月開始推出 ChatGPT(T就是Transformer , 而GP代表Generative Pre-trained)後, 全世界為之改觀, AI浪潮席捲全球, 智慧居然能夠經過電腦的運算自己產生出來, 有點匪夷所思. 我們都知道世界上其他有體溫, 會動的物種, 都有某種程度的智慧, 但是比起人的智慧, 那真是微不足道. 而現在, 非生物系統, 沒體溫, 不會動的電腦, 在經過複雜運算後, 也能夠產生智慧, 而這種智慧竟然會遠遠凌駕在我們人類智慧之上, 這會讓許多人惴惴不安,徹夜難眠. 現在我們大部分人都玩過AI, 有問題找AI問, AI會不厭其煩地仔細回答, 這是”知其然”, 知道AI是靠電腦, 但是如果要”知其所以然”, 要想知道為什麼AI有這麼龐大的智慧回答五花八門的問題, 就不得不從電腦的運算程式去深刻了解, 運算的本身為什麼會產生智慧.
智慧(Intelligence) 到底是甚麼? 照一般的定義, 智慧是能夠 learn, reason, understand, solve problems, and adapt to new situations。一個人如果有這些能力, 內在的表現就是能夠” learn, reason, understand,”, 外在的表現就是能夠solve problems, adapt to new situations. 我們人類有智慧, 大家公認. 今天這裡就不談其他物種是否有智慧.只談出生嬰兒如何取得智慧 (圖一). 眾所皆知, 嬰兒在生長的過程中, 是經過”學習, feedback and adjust”反覆演練, 一天一天地吸收成長, 才獲得智慧.而AI也是經過”學習(training), feedback and adjust “的反覆演練, 才變成一個有智慧的AI.今天要講的是筆者如何設計小的AI (姑且叫”TinyLLM”) 來了解AI到底是如何取得智慧. 在講到本題之前, 我們先給一個我們使用的商業用, 大AI模型的例子.
AI如何給你答案: 你打開一個AI的App, 比如ChatGPT, 它就說你要問什麼問題. 你就輸入一個問句,比如: “What color is sky?"對AI來講, 你給了四個英文字及一個問號. AI把英文字和問號統統叫做”token”. 所以現在你給它的, 就是5個tokens. 大AI模型有多少個tokens? OpenAI 2022年推出的一個有12,288個緯度的GPT-3.5,裡面就有約10萬個tokens, 包括英文字,中文,日文,韓文,法文,德文等等以及其他種種符號.現在你給它5個tokens.AI就開始處理這五個tokens, 目標是 預測下一個token. 方法是計算這十萬多個tokens的或然率(一大堆的矩陣運算). 一般, 或然率最高的就是下一個token.現在加進這個新token, 你就有了6個tokens.AI就把這6個tokens用同樣方法處理,得到下一個token.如此這般,得到最後一個叫”stop”的token時,它就把整個答案送給你.所以, 不管你的問句有多少個tokens, AI一接到你的input, 就悶頭計算,給你答案.所以有人說, AI很簡單,無非就是決定下一個token是甚麼而已.看來簡單是簡單,但是你如果是內行人,知道像是GPT – 3.5這樣的AI,有578個矩陣,這些矩陣的參數總加起來幾乎有兩千億個,你就知道裡面計算之多,絕對不可思議.為什麼把AI搞到幾千億個參數這麼大? OpenAI主要是要盡量網羅所有人類的digitized的知識, 收集起來作為訓練OpenAI的語言模型之用. 針對的是整個世界, 全人類, 所以包羅萬象,參數不得不就衝上幾千億個,而訓練用的文句拆成一個一個的字體後, 總tokens數量約三千億個.這種大型的AI都是商業用, 也只有財力雄厚, 軟體工程師一大堆的大公司才能夠開發出來.一般人, 在使用這種大型公司的產品之後,都不得不佩服這種大型AI的學術淵博,能力高強,速度奇快,而且它的generative能力還能製作出新的AI音樂,AI影片這種Google Search絕對辦不到的東西.AI經過訓練後,具有智慧,所以能夠創新.但是,講白一點,AI無非是龐大的計算.那麼,這智慧到底是怎麼從計算中產生出來的?
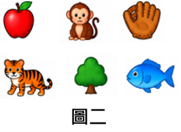
設計小型的AI – TinyLLM: 為了瞭解智慧到底是怎麼從計算中產生出來的,筆者設計了一個只有8個緯度的小型AI,TinyLLM只有10個tokens: heart, umbrella, tree, bucket, monkey, apple, tiger, boat, fish, glove. 除了這10個tokens外, TinyLLM有6個矩陣,矩陣總參數424個.這個小AI的功能跟ChatGPT一樣, 預測下一個token. 筆者給TinyLLM的訓練有40條,每條有三個tokens.訓練的規矩很簡單, 就是你看到每條的前兩個tokens, 你的“next token”就是第三個. 比方圖二的第一行:你看到apple, monkey這兩個tokens, 好好記住, 你的”next token”就是glove. 走到第二行, 你看到tiger, tree這兩個tokens, 好好記住, 你的”next token”就是fish.
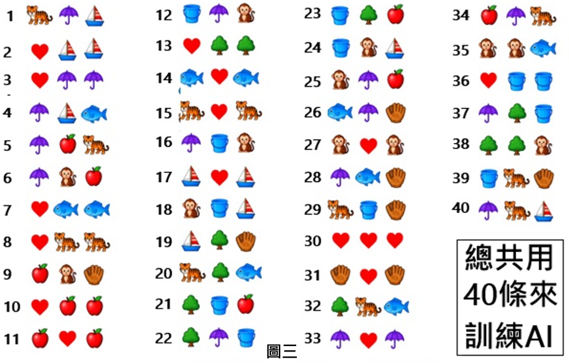
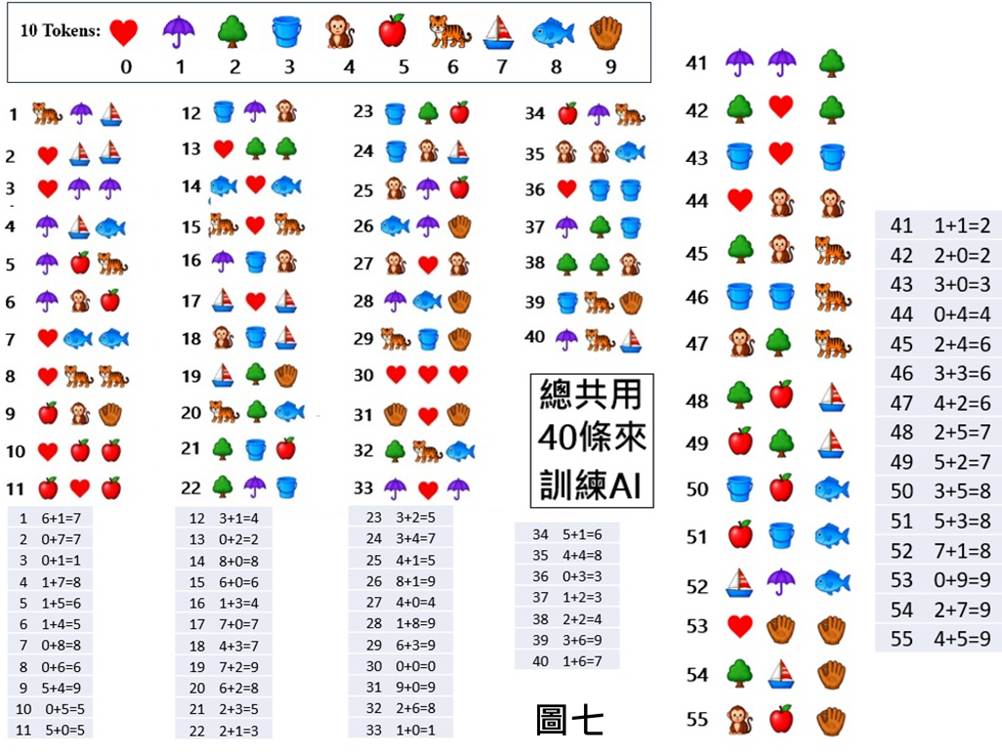
所謂訓練, 其實就是去執行電腦的程式. 筆者叫AI幫忙寫Excel VBA的程式. 經過驗證(debug)無誤後. 訓練就開始. 每個token都用一個8個數目 (因為緯度=8) 的”向量”來代表. 剛開始這8個數目都是隨機數. 每個矩陣裡面的參數剛開始也都是隨機數. 第一行的apple, monkey, glove的訓練過程就是把apple的”向量”及 monkey的”向量”帶進各個矩陣內去算出這10個tokens的或然率. 算完後, 不管這10個或然率的大小, 回頭去矩陣裡面的每個參數做小小的調整, 同時也調整apple, monkey, glove三個 ”向量”的參數. 調整的唯一目標就是稍微改變每個參數,使其朝著降低預測誤差的方向去做”微整形”。 然後進入第二行的tiger, tree: 把tiger的”向量”及 tree的”向量”帶進各個已稍微調整過的矩陣內去算出這10個tokens的或然率.然後回頭去矩陣裡面的每個參數做小小的調整, 同時也調整tiger, tree, fish三個 ”向量”的參數, 讓預測誤差越來越小. 如此這般, 把應該訓練的每一行全部做完後, 去計算總誤差 (cross-entropy loss). 這是第一輪. 如果總誤差過大, 用已調整過的參數出發, 走第二輪. 如此這般, 讓總誤差小到一個程度才停止. 訓練於是完成. 圖三所示是筆者給小AI訓練用的40行.
圖四是成功訓練出來的6個矩陣的424個參數值.
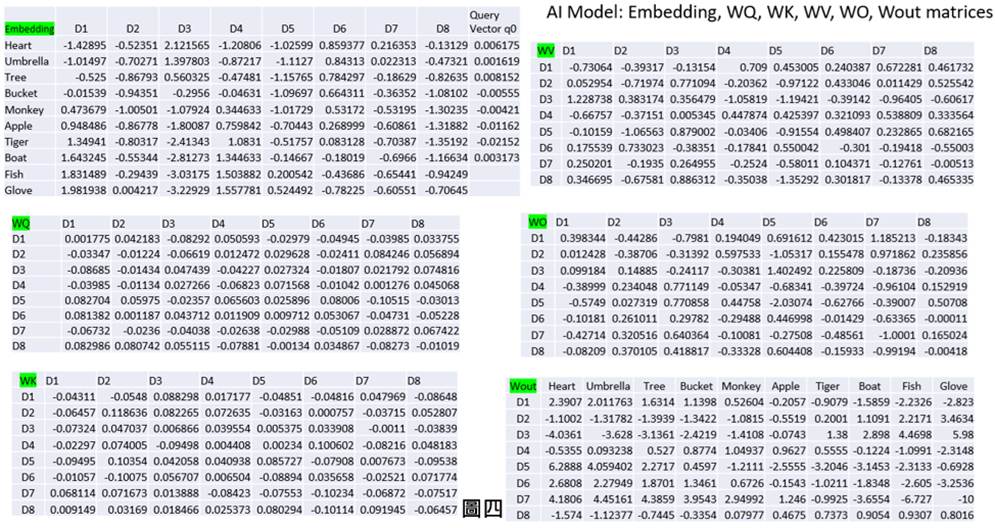
請注意, TinyLLM所有訓練的東西, 全部揮發(蒸發)成數目字, 分布在眾多的參數裡面. ChatGPT也是一樣, 所有用在模型訓練的Encyclopedia的英文句子, 所有莎士比亞名著的文句, 以及李白杜甫的詩文, 全部揮發成數目字, 分布在幾千億個參數裡面, 整個模型裡找不到一句訓練用過英文, 找不到一句訓練用過中文.
TinyLLM的Next Token預測能力 – memory:
在圖四裡的6個矩陣就是筆者的小AI模型, TinyLLM. 這個模型靈不靈, 簡單的預測就是用圖三的訓練組. 把每一行的第一及第二個tokens輸入給TinyLLM, 看TinyLLM有沒有能耐準確地預測出第三個token.
測試結果, 每一行都正確地得到第三個token. 這就表示這個TinyLLM有記憶的能力; 訓練它, 讓它看到的40行, 它都全部給記住了. 它的memory不是放在電腦的某一個地址裡面, 而是分佈在眾多的參數裡面.
TinyLLM的Next Token預測能力 – generalization/intelligence:
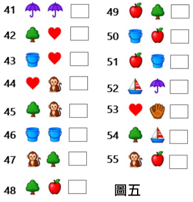
在40行的訓練組之外, 筆者還有15行的測試組, 如圖五所示. 這15行都與訓練組的40行不同, TinyLLM也從來沒有看過這些. 比方第41行. 兩個雨傘在一起的, 沒有出現在訓練組的任何一行裡, 是新的東西. 經過訓練組的40行訓練出來的TinyLLM, 有沒有領悟到甚麼, 可以用來預測第41行的next token?
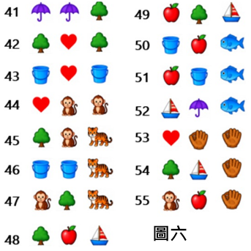
測試結果, 每一行都正確地得到第三個token (圖六). 這就表示這個TinyLLM經過訓練後, 確實有領悟到記憶力以外的東西, 不然它沒有能力把15題都做對. 所以我們說這個TinyLLM有generalization的能力; 能夠solve problems, and adapt to new situations.這就表示它有相當程度的”智慧”.
經過訓練後的TinyLLM到底領悟到什麼東西:
眼尖的讀者說不定已經從圖三, 40行的訓練組裡面仔細檢查後, 看出一些苗頭, 領悟到背後的一些規則. 其實說穿了, 前40行加上後15行就是小學算數課老師在課堂教的簡單加法: 兩個數目加起來不超過9. 所以, 0+0=0, 0+1=1, 1+0=1, 1+1=2, 0+2=2, 2+0=2, … 4+5=9, 5+4=9, 共有55 條. 而數目字與tokens的對照表就是如圖七所示: heart=0, umbrella=1, tree=2, bucket=3, monkey=4, apple=5, tiger=6, boat=7, fish=8, glove=9. 經過這樣講白了之後, 第41行的兩支雨傘一顆樹就是1+1=2. 第55行的猴子,蘋果,棒球手套就是4+5=9.
筆者在做40行訓練的時候, 並沒有告訴TinyLLM這些tokens是代表甚麼. 也沒有告訴每一行的三個tokens的關係是算術加法的關係. TinyLLM只是被訓練, 告知如果第一第二個tokens是這樣這樣,那麼next token就應該是那樣. 訓練的過程就是如上面所講的. 經過40行的訓練下來, 所得到的模型, 不僅有完整的記憶力, 還有推理的能力, 居然把背後的算數加法的答案給算出來, 絲毫不差. 說這個TinyLLM”領悟”出算數加法的原理, 好像不太恰當, 因為這個模型就是圖四的那些冷冰冰的數目字而已. 這群沒體溫的數目字會”領悟”?有點說不通. 但是它確確實實把55道算數加法都給答對! 這可能就是artificial intelligence的真諦!
大型AI的智慧:
這裡所討論的TinyLLM, 需要的數學不是很多, 寫的VBA電腦程式也只有五六百條, 是屬於簡單的單層”深度學習”. 小是小, 但是也具有相當程度的算術智慧. 原因是訓練的資料是建立在算數的領域. 這個小數學式的TinyLLM, 它的世界很小, 只有10個tokens, 而背後的規則是算術的加法. 反觀超大的AI模型就不同了, 比如GPT-3, 訓練的過程是用 96層的”深度學習”, 它的訓練用龐大資料, 是建立在人類社會所用的, 已經數位化的語言句子上, 這些資料背後的規則其實就是各種語言的文法結構 (也包括算數加法; 因為GPT-3 也會做算術). 所以訓練出來的GPT-3, 講的就是你我都聽得懂的人話, 表現出來的邏輯, 也是你我都熟悉的邏輯. 也就是說, 餵給什麼樣的資料, 就會產生什麼樣的AI模型. 不過不管是這裡討論的小數學式TinyLLM , 或是商業用的GPT-3大模型, 功能是一樣的: 預測下一個token(字). 在小數學TinyLLM內, 我們的下一個token就是答案. 但是在大模型的GPT 3裡面, 要好多個下一個token才能組成一個句子, 而句子是否代表智慧, 這就需要解釋. 我們不應該以AI有記憶力來衡量它的智慧, 而要以AI有能力處理從來沒有看過的狀況. 比方,在訓練時, 讓AI看三個句子: 甲把鞋子放進紅盒子裡, 乙把紅盒子放在櫃櫥裡, 丙把櫃櫥移到隔壁的房間. 當訓練成功後, 問AI這樣的問題: “鞋子在甚麼地方?”. 要知道, 在訓練時, 是沒有一句” 鞋子在某某地方”. 所以, “鞋子在甚麼地方?”是新的狀況. 如果AI的答案是”在隔壁房間”, 那就是有了智慧. AI之所以有智慧, 要簡單解釋的話, 就是在訓練的時候, 努力” 建立關係網,然後透過一層一層「順藤摸瓜」的數學運算,把相關資訊串聯起來,最後算出下一個 Token 的機率,選出下一個 Token”. 有人可能會懷疑, 這種”預測下一個Token”的冷冰冰運算就能說是有智慧嗎? AI會有意識 (consciousness)嗎? AI教父Prof. Hinton認為AI有智慧, 也有意識. 有興趣的讀者可以到ChatGPT, Gemini, 或 Anthropic 這些大型AI去問問看, 或是上YouTube去看, 這方面的討論很多. 另外, AI會毀滅人類嗎? 人類如何才能控制AI? 更是有熱烈的討論.
結論:
本文所討論的TinyLLM雖然小, 但是具有AI的主要功能, 能夠記憶, 而且還能夠推理,能夠做generalization. 它所 deal with 的, 是一個算數範圍的小世界. 筆者給予有算數精髓的訓練, 它就變成是一個能夠做算術的AI. ChatGPT是一個人類社會的大世界, OpenAI給予它人類語言精髓的訓練, 它就變成能夠用人類思考模式來對答的AI. 這種大AI所展現的智慧形態,不可諱言地正坐擁著傳統碳基生命難以企及的數位優勢。憑藉電腦近乎無限的龐大記憶體與巨量數據處理能力,這些大語言模型將浩瀚如煙海的萬物知識融會貫通,呈現出無與倫比的廣博視野;而其匪夷所思的運算與進化速度,更讓人類的智慧萬難企及. 當AI的凌駕與超越人類已成為必然的歷史浪潮,這項發明便不僅僅是科技史上的又一次躍進,更是將整個人類文明推向了一個史無前例的轉捩點。這是一場重劃智慧邊界的革命,而人類文明也將在這場深刻的轉折中,迎來劇烈的蛻變與重組。
(2026-10-03 New Jersey).
<2026-10-04>